写匠大模型入驻活水模型:校对「忍得住」,排版「编得过」
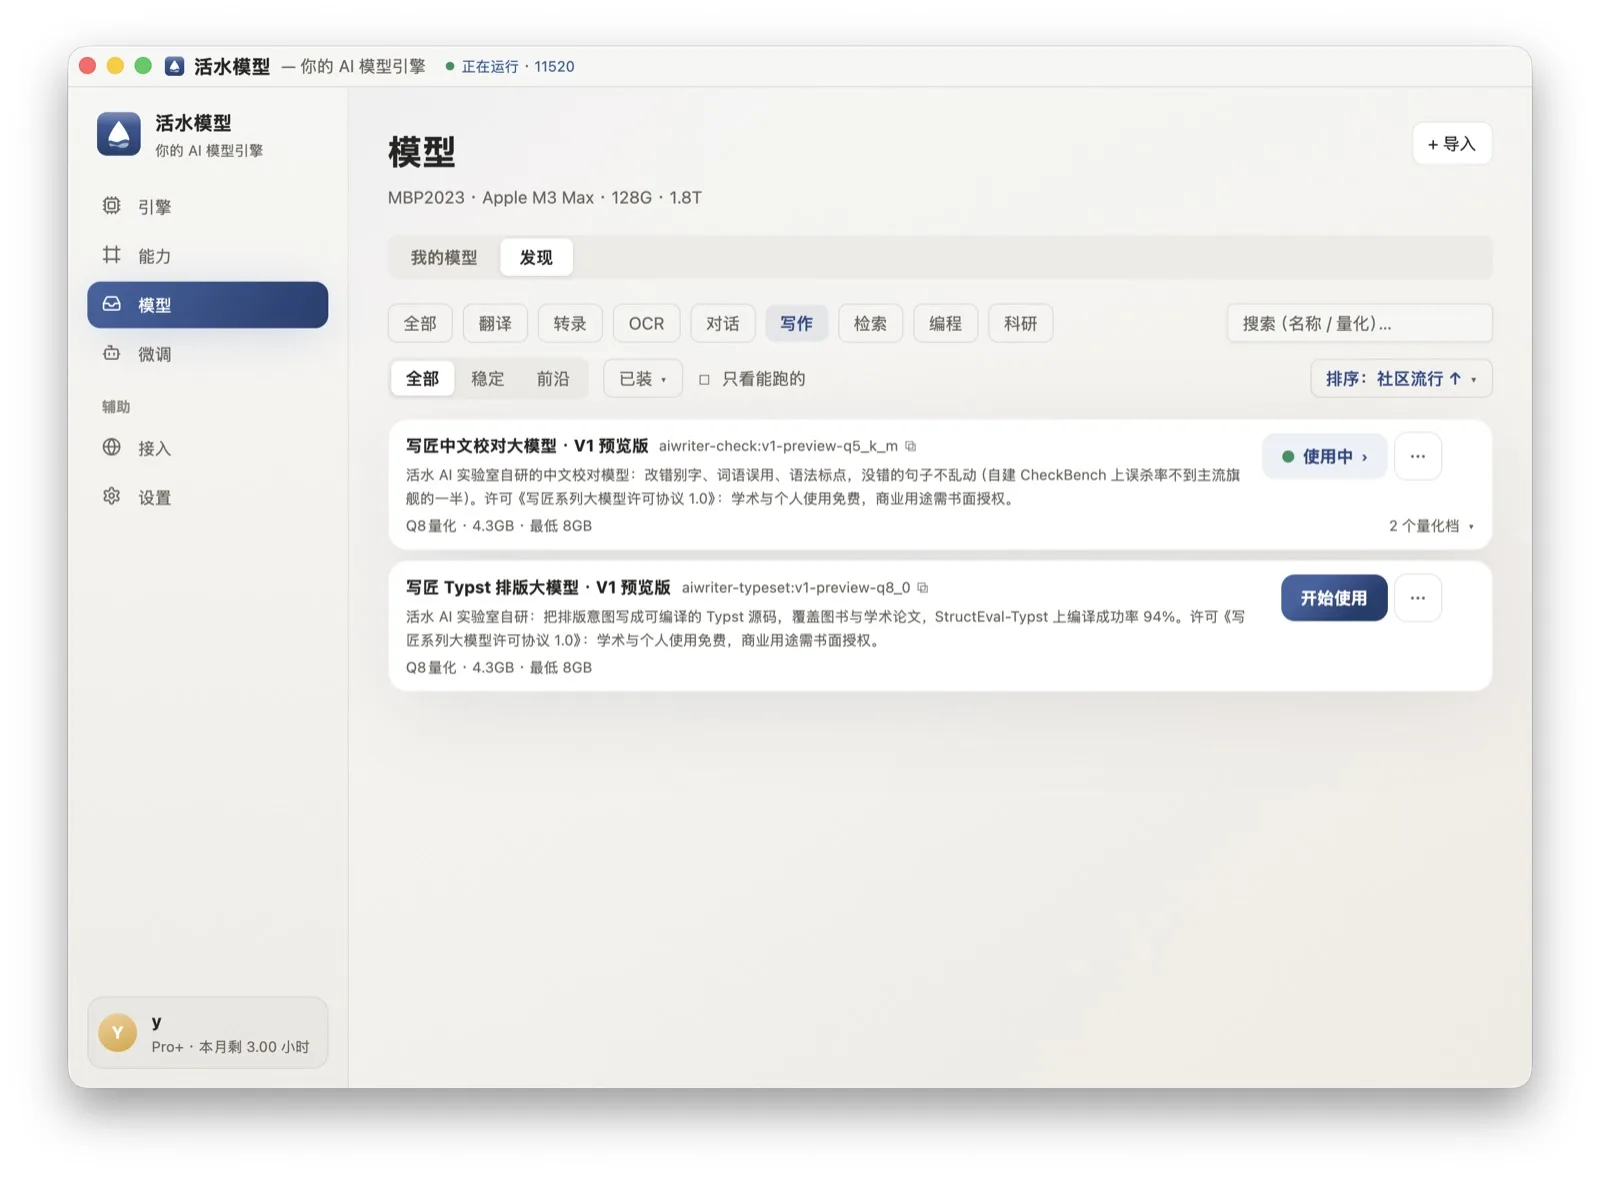
给大模型一句本来就没错的话让它校对,四个主流旗舰里 43% 到 50% 会动手改。写匠中文校对大模型把误杀率压到 19.92%。加上 Typst 排版大模型,两个 4B 模型现已可在活水模型一键下载,桌面还新增了「写作」页,打开就能用。
给一个大模型一句话让它校对,它几乎总能改点什么——哪怕这句话本来就没错。
我们实测四个主流旗舰,在本来就没有错的句子上,43% 到 50% 会被动手改。
这两类错误的代价不等。漏检只是没帮上忙,那句作家本来也要自己再看一遍;误杀是帮了倒忙,要么被发现、再改回来,要么没被发现,错就留在书里。
写匠系列的两个 4B 模型——中文校对与 Typst 排版——现已可在活水模型一键下载。
校对:难的是忍得住
写匠中文校对大模型把误杀率当作与主分并列的一等指标来优化。在自建的 CheckBench 中文校对基准上:
| 模型 | 参数量 | 净收益 ↑ | 误杀率 ↓ | 纠错得分 |
|---|---|---|---|---|
| 写匠 V1 校对 | 4B | 30.6 | 19.92% | 50.53 |
| DeepSeek-V4.1-Flash | — | 14.0 | 45.3% | 59.34 |
| qwen3.8-flash | — | 12.4 | 43.4% | 55.83 |
| GLM-5.2 | — | 6.6 | 50.4% | 56.99 |
净收益把两列合成一个数:纠错得分减去误杀率乘一百。系数取的是对本模型最不利的那档——改错一次恰好抵消改对一次——它仍领先第二名 16.6 分。
CheckBench 是活水自建的基准,不是第三方公开榜单。
输入「并做出了相映的调整」,它给出「并做出了相应的调整」。再输入一句本来就没错的话——「写作这件事,说到底是把想清楚的东西一句一句落到纸上。」——它逐字原样返回,一个标点都没动。
排版:编译不过的排版,结构再漂亮也等于零
写匠 Typst 排版大模型把排版意图写成可编译的 Typst 源码,覆盖图书与学术论文两类场景。
所以训练时把 render 率——能不能成功编译——当作首要指标,而不是只看版面评分。
在公开基准 StructEval-Typst 上:
| 排名 | 模型 | 规模 | 总分 | render ↑ |
|---|---|---|---|---|
| 1 | Kimi-k2.7-code | — | 78.99 | 92% |
| 2 | 写匠 V1 排版 | 4B | 76.12 | 94% |
| 3 | DeepSeek-V4.1-Flash | — | 75.57 | 84% |
| 7 | Qwen3.5-397B | 397B | 57.37 | 62% |
| 8 | Qwen3-4B(同基座·未经训练) | 4B | 9.94 | 0% |
render 率 94%,高于所有受测旗舰。同一个基座未经训练时是 0%,一份都编译不出。从 0 到 94%,差的是训练。
版面评分用开源多模态模型近似(官方口径用 GPT-4o 系),render 与关键词复刻官方逻辑;表中部分行取自不同批次的对位测试,两批外部模型的调用协议不完全一致,并列时请留意。
桌面新增「写作」页
这一版桌面端多了「写作」一格。页内可以在中文校对和 Typst 排版之间切换,切一下就换模型,贴一段文字、点「开始」、拿走结果。
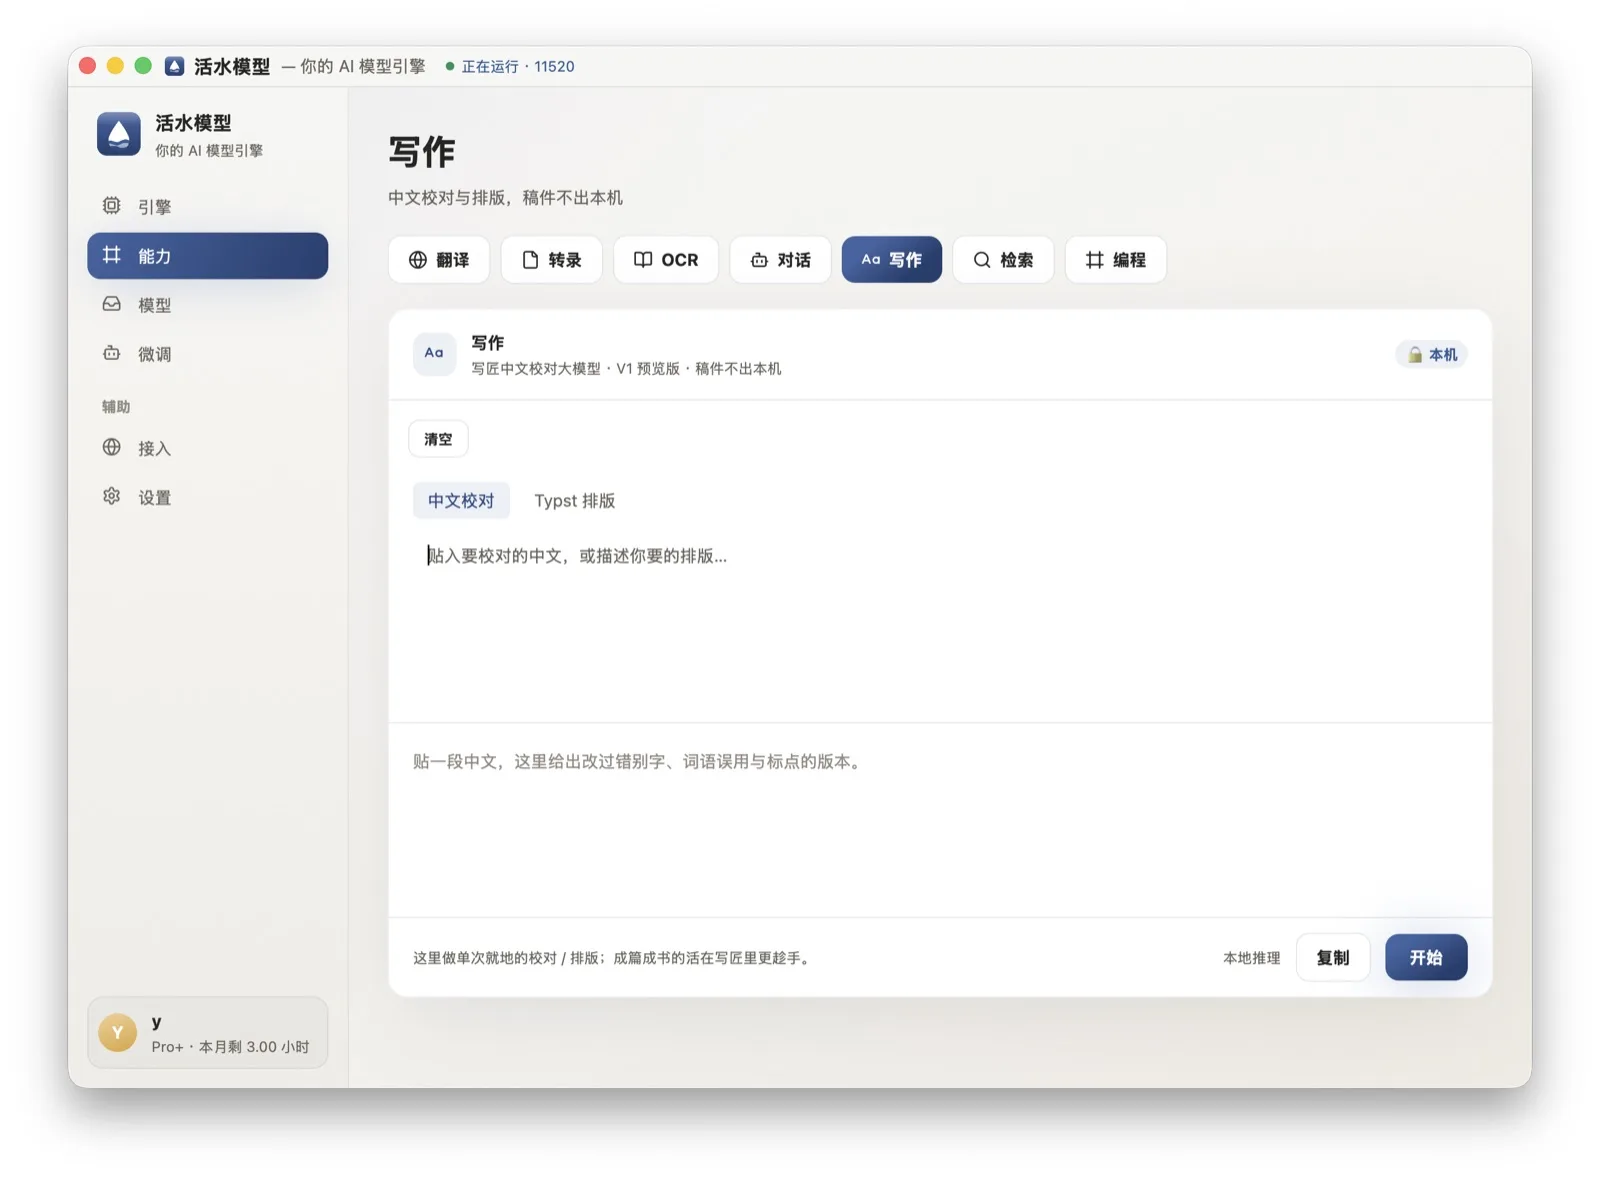
这一页只做单次、就地的活。成篇成书的写作流程仍归写匠应用,页面底下那行字会指路过去。活水模型是引擎层,写匠是应用层,两个产品不做同一件事。
预览版与许可
两个模型都还是 V1 预览版,尚未定版,正式版将在写匠新品发布会后发布。排版模型当前的指令遵循还不到位——比如你给定的标题,它有时会自己改写一个。
许可和库里其他模型不一样。 两个模型用的是《写匠系列大模型许可协议 1.0》:学术研究与个人使用免费,含微调与衍生;商业用途需书面授权,专利保留。库里其余的开源模型多是 Apache-2.0 或 MIT,这两个不是。
怎么拿
打开桌面版,模型库里点「写作」。校对模型有 4.3GB 和 2.9GB 两档,普通笔记本都跑得动。装完在「能力 → 写作」里直接用,全程断网可用,稿件不出本机。
你用 AI 校对或润色时,有没有遇到过它把你本来没写错的地方改掉了?当时发现了没有?
活水 AI 实验室(42ailab) — 探索智能边界的 AI 创新实验室,以认知科学为基石,推动 AI 与人类智能的深度融合,真正理解并增强智能 —— 碳基的,也是硅基的。
活水模型(42model) — 由活水 AI 实验室出品的高性能本地 AI 大模型推理引擎,让翻译、转写、识别、对话、编程等 AI 能力在你的本机免费私密运行;并可借云端算力微调专属模型,回传本机运行。