活水模型上线科研大模型:查资料、追线索、证定理,五个开源模型跑在你自己的电脑上
竞品调研、尽职调查、内部资料整理,这类活儿要查十几个来源、走几十步才收敛,而每一步都得把线索交给云端。活水模型新增「科研」分类,首批收录五个开源大模型,8GB 内存的机器就能起步,资料全程不出本机。文末附三步接入指南与 Lean 4 证明的上手方法。
有些问题一次问答答不完。核一个说法的出处、把散在十几个页面里的信息拼成一张表、顺着线索一层层往下追——这类活儿要的不是一次说得漂亮,是长时间不跑偏。
过去要用这种能力,得把你的问题、你查的东西、连同中途读到的内部资料,一并交给云端。做竞品调研、尽职调查、内部资料整理的人,在这一步都会犹豫一下。
活水模型新增「科研」这一格,把负责思考与决策的那一半搬回本地。首批五个开源大模型,全部免费。
先说背景:这类模型和聊天模型不是一回事
过去两年,开源社区长出了一支专门的模型线,英文叫 deep research agent。它们训练的目标不是把一个问题答得漂亮,而是在一个任务里连续做几十上百次判断:现在该搜什么、这页值不值得读、读到的东西和上一条矛盾了怎么办、什么时候可以收手。
所以它们有两个和聊天模型很不一样的地方。
一是上下文特别长。一次任务要装下几十轮的查阅记录,131K 起步,长的到 256K。
二是工具调用是主线而不是点缀。MiroThinker 的上游明确说它按单任务 300 次工具调用来设计。聊天模型偶尔调个函数,这些模型是整场都在调。
代价是,它们离开工具就不好用。你把一个 deep research 模型当普通聊天模型问「今天天气怎么样」,体验会不如同尺寸的对话模型——那不是它的用法。这一点后面还会再说一次。
另一支是形式化定理证明。这条线更小众也更硬:输入是已经写成 Lean 4 的定理陈述,输出是能过编译器的证明代码。它不理解「帮我证明一下勾股定理」这种话。
首批五个模型
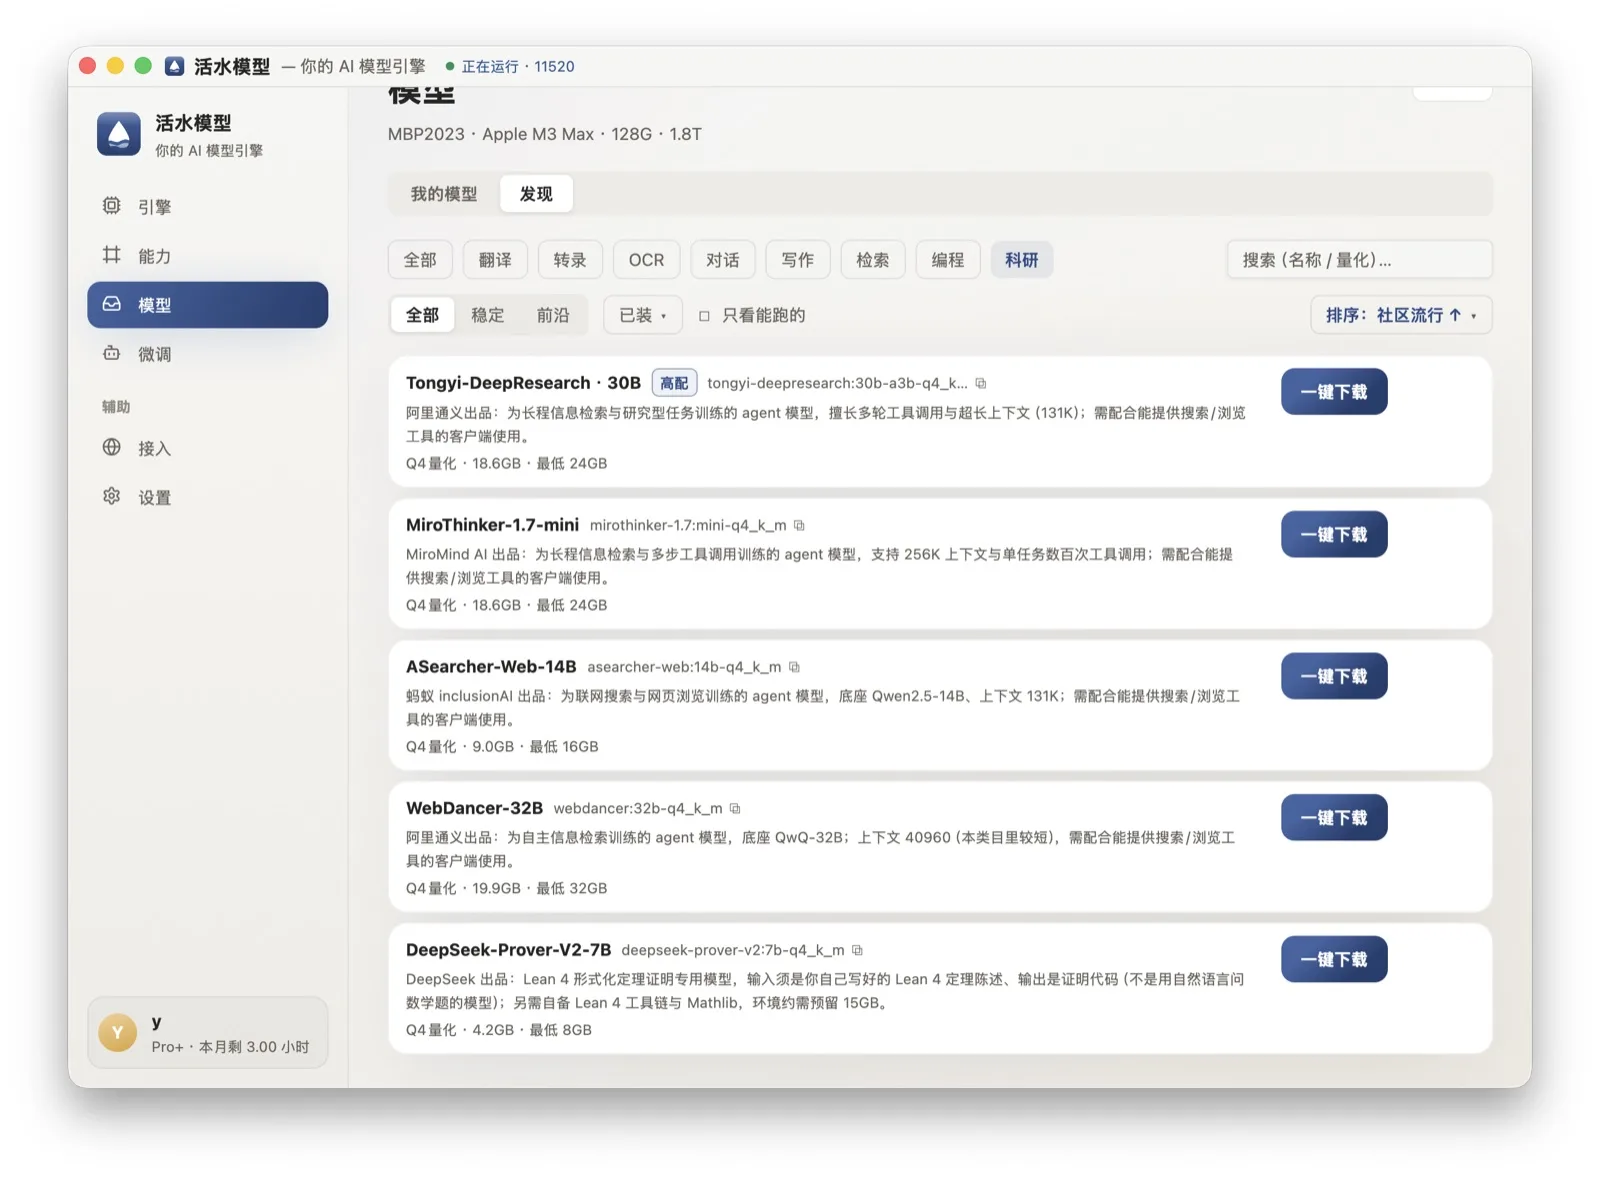
四个做长程信息检索,一个做形式化定理证明。
Tongyi-DeepResearch-30B-A3B,阿里通义出品,为长程信息检索与研究型任务训练,上下文 131K,18.6GB,建议 24GB 内存。这是「科研」这一格的默认推荐档。
MiroThinker-1.7-mini,MiroMind AI 出品,256K 上下文,上游按单任务 300 次工具调用设计,18.6GB,建议 24GB。
ASearcher-Web-14B,蚂蚁 inclusionAI 出品,底座 Qwen2.5-14B,专攻联网搜索与网页浏览,上下文 131K,9.0GB,16GB 内存可跑。
WebDancer-32B,阿里通义出品,底座 QwQ-32B,做自主信息检索,上下文 40960(这一批里较短的一个),19.9GB,建议 32GB。
DeepSeek-Prover-V2-7B,DeepSeek 出品,Lean 4 形式化定理证明,4.2GB,8GB 内存的机器就能起步。
许可都是可商用的 Apache-2.0 或 MIT。
其中一个是活水自己转的
MiroThinker-1.7-mini 上游只发布了原始权重,没有能在消费级设备上直接跑的量化版本。活水 AI 实验室自己做了格式转换和量化,又在自家引擎上完成加载与生成校验,把 61.1GB 压到 18.6GB 的单个文件,约为原来的三成。
这份量化档同步发布在 ModelScope 和 Hugging Face,逐字节可校验,谁都能取用。
怎么用:四个检索模型
这类模型的门槛主要在「谁给它工具」。活水模型负责把模型按标准协议端出来,搜索和浏览由你的客户端提供。三步接上。
第一步,下载并让引擎跑起来。
打开桌面版,模型库里点「科研」,按自己机器的内存挑一个,点「一键下载」。命令行用户:
42model download tongyi-deepresearch:30b-a3b-q4_k_m
42model serve
引擎常驻在本机 11520 端口,只有一个端口、一个常驻进程。
第二步,把端点填进你的客户端。
桌面版左侧「接入」页里有可直接复制的地址,两个协议:
OpenAI 协议      http://localhost:11520/v1
Anthropic 协议   http://localhost:11520
API 密钥默认是 42model,可以在设置里改成你自己的。任何兼容 OpenAI 或 Anthropic 接口的智能体客户端都能接——你手边那个带搜索和网页浏览工具的 agent,把 base URL 指过来就行。
第三步,在客户端里把模型名选成你下的那个。
模型名就是模型库卡片上那串 id,比如 tongyi-deepresearch:30b-a3b-q4_k_m,卡片上点一下就复制。
接上之后,客户端负责去搜、去抓网页,模型负责判断下一步查什么、什么时候收手。整条链里,你的问题和读到的内容都留在这台机器上。
选哪个?16GB 的机器用 ASearcher-Web-14B,24GB 用 Tongyi-DeepResearch,要装很长的查阅记录就换 MiroThinker-1.7-mini 的 256K,32GB 且偏好稠密模型的用 WebDancer-32B。
怎么用:Lean 4 定理证明
DeepSeek-Prover-V2 的用法和上面四个完全不同,值得单独说。
先装 Lean 4 环境。官方工具链约 1GB,配套的 Mathlib 数学库编译缓存 4 到 5GB,社区建议预留 15GB 左右——比模型本身大四倍,这是真正的门槛所在,模型反而是最小的那块。
然后,喂给它的必须是已经形式化好的定理陈述,加上官方那句固定开头:
Complete the following Lean 4 code:

```lean4
theorem my_thm (n : Nat) : n + 0 = n := by
  sorry
```
它会把 sorry 换成证明。你拿输出回 Lean 编译,过了就是过了。
所以它服务的是已经在用 Lean 写形式化数学的人。如果你想要的是「用中文问一道数学题」,这个模型帮不上忙,「对话」那一格里的通用模型更合适。
另外,上游把 7B 定位成流水线里给每个子目标做证明搜索的小工,真正那些亮眼的成绩来自 671B 的大模型。这一档是给本机跑的,预期照此设定。
三件先说清楚的事
这些模型需要一个会给它工具的客户端。 上面说了两次,因为它是这一格里最容易踩空的地方。搜索、浏览网页这些工具不在模型里,编排也不在引擎里。活水模型只负责把模型按标准协议端出来。
这一批里没有旗舰。 真正顶尖的那几个科研模型是数百 GB 量级,消费级设备跑不动,收进来的全是中小档。这一格解决的是能不能在自己机器上做这件事。
科学多模态那一支这次是空的。 化学式、蛋白序列、材料结构那类模型,我们试过的候选在格式转换这一步就卡住了,等上游支持。这一格现在只有检索和证明两支。
怎么拿
打开活水模型桌面版,模型库里点「科研」。命令行用 42model download。全部免费。
活水 AI 实验室(42ailab) — 探索智能边界的 AI 创新实验室,以认知科学为基石,推动 AI 与人类智能的深度融合,真正理解并增强智能 —— 碳基的,也是硅基的。
活水模型(42model) — 由活水 AI 实验室出品的高性能本地 AI 大模型推理引擎,让翻译、转写、识别、对话、编程等 AI 能力在你的本机免费私密运行;并可借云端算力微调专属模型,回传本机运行。