创作
写作:校对与排版
写匠中文校对与 Typst 排版两个 4B 模型,桌面版「写作」页打开就能用。
「能力 → 写作」页有中文校对、Typst 排版、幻灯片三个模式,本页讲前两个,幻灯片见幻灯片。切一下就换模型,贴一段文字、点「开始」、拿走结果,全程断网可用,稿件不出本机。这一页只做单次、就地的活;成篇成书的写作流程归写匠应用,活水模型是引擎层。
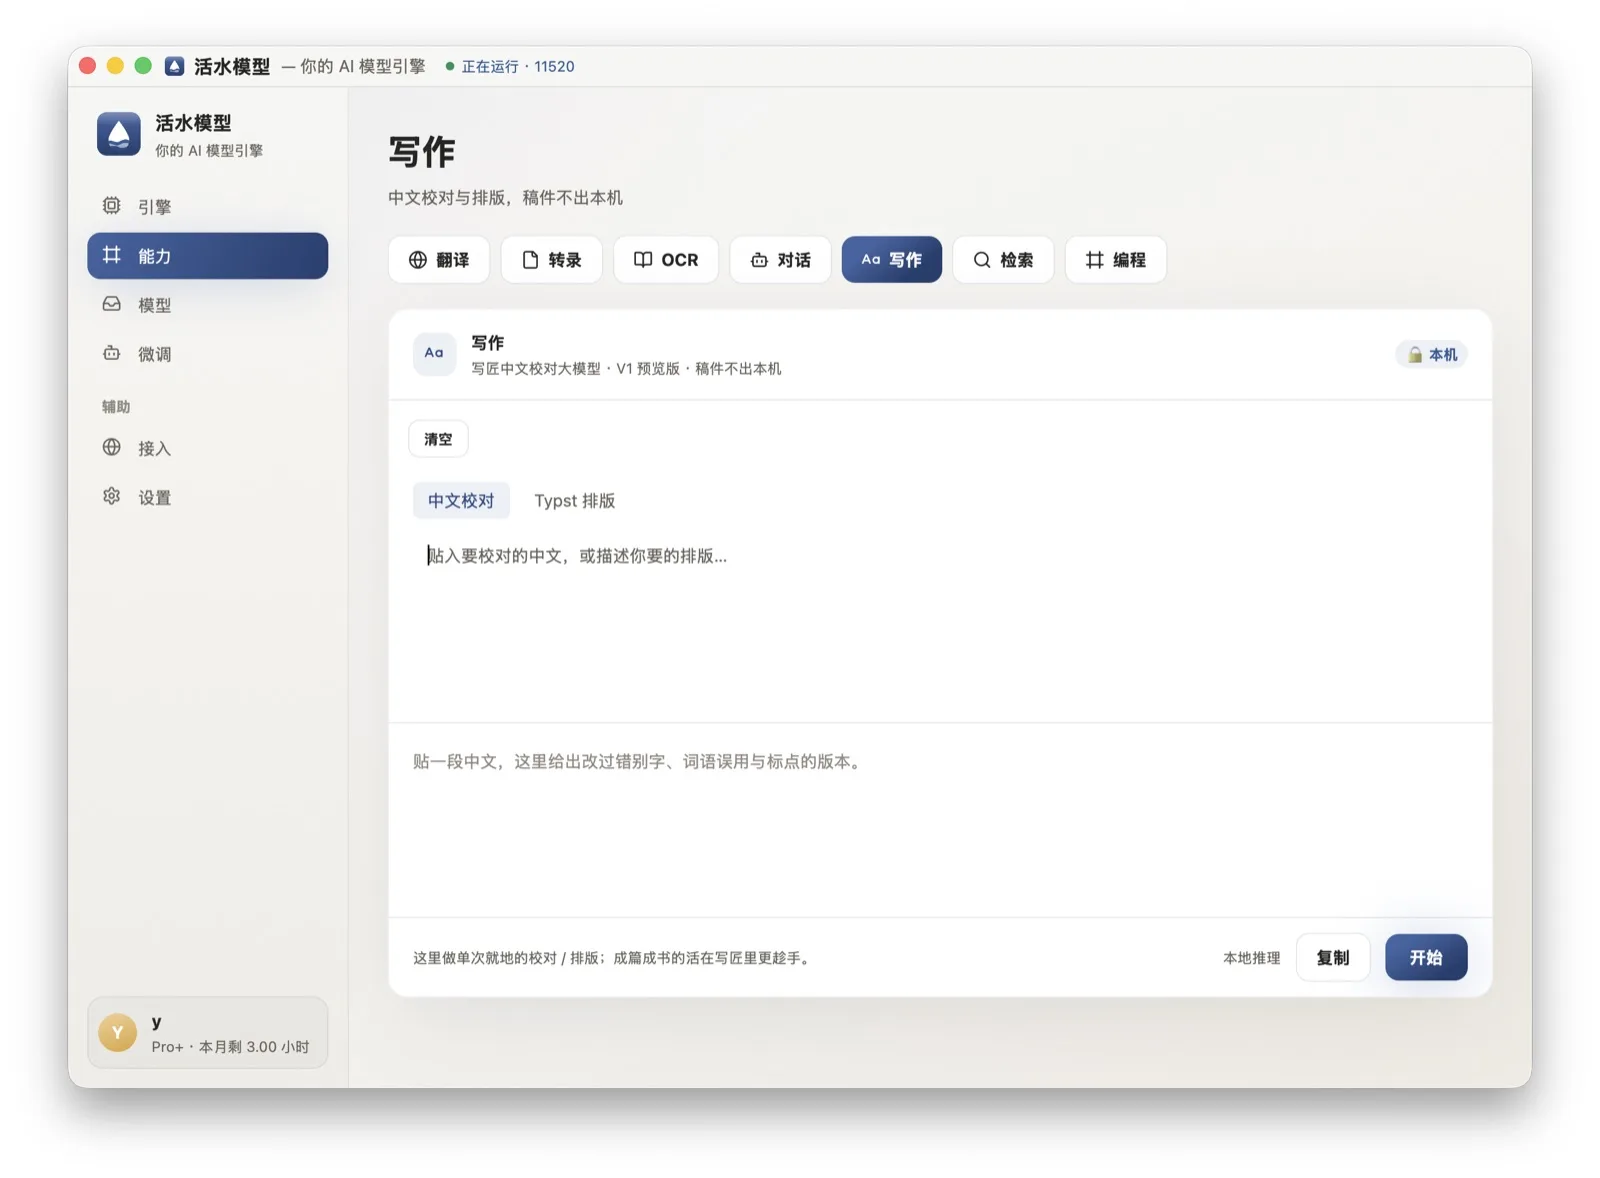
中文校对
写匠中文校对大模型(4B)把「误杀率」——把本来没错的句子改错——当作与得分并列的一等指标。在活水自建的 CheckBench 中文校对基准上:
| 模型 | 参数量 | 净收益 ↑ | 误杀率 ↓ | 纠错得分 |
|---|---|---|---|---|
| 写匠 V1 校对 | 4B | 30.6 | 19.92% | 50.53 |
| DeepSeek-V4.1-Flash | — | 14.0 | 45.3% | 59.34 |
| qwen3.8-flash | — | 12.4 | 43.4% | 55.83 |
| GLM-5.2 | — | 6.6 | 50.4% | 56.99 |
净收益 = 纠错得分 − 误杀率(按百分点计,如 19.92% 记 19.92)。CheckBench 是活水自建的基准,不是第三方公开榜单。
输入「并做出了相映的调整」,它给出「并做出了相应的调整」;输入一句本来就没错的话,它逐字原样返回。校对模型有 4.3GB 和 2.9GB 两档,普通笔记本都跑得动。
Typst 排版
写匠 Typst 排版大模型(4B)把排版意图写成可编译的 Typst 源码,覆盖图书与学术论文。训练时把 render 率(能否成功编译)当作首要指标。在公开基准 StructEval-Typst 上:
| 排名 | 模型 | 规模 | 总分 | render ↑ |
|---|---|---|---|---|
| 1 | Kimi-k2.7-code | — | 78.99 | 92% |
| 2 | 写匠 V1 排版 | 4B | 76.12 | 94% |
| 3 | DeepSeek-V4.1-Flash | — | 75.57 | 84% |
| 7 | Qwen3.5-397B | 397B | 57.37 | 62% |
| 8 | Qwen3-4B(同基座·未经训练) | 4B | 9.94 | 0% |
版面评分用开源多模态模型近似(官方口径用 GPT-4o 系),表中部分行取自不同批次的对位测试,两批外部模型的调用协议不完全一致,并列时请留意。
预览版与许可
- 两个模型都是 V1 预览版,尚未定版。排版模型当前的指令遵循还不到位,比如你给定的标题它有时会自己改写。
- 许可是《写匠系列大模型许可协议 1.0》:学术研究与个人使用免费(含微调与衍生),商业用途需书面授权,专利保留。库里其余开源模型多为 Apache-2.0 或 MIT,这两个不是。
怎么拿
桌面版模型库里点「写作」下载,装完在「能力 → 写作」里直接用。
下一步
- 同在「写作」页的幻灯片模式:幻灯片