模型
测速:你的电脑跑多快
每个模型点一下「测速」,最快几秒出一份可直接发给别人看的报告。
想知道某个模型在你这台电脑上跑多快,不用再自己掐表数字数。
怎么测
在「我的模型」或模型库里,每个模型行末尾的「⋯」菜单中选「测速」。小模型几秒钟,几十 GB 的大模型要一分多钟——它要先把模型整个载进内存,这个耗时本来就是要报的数之一。
命令行同样可用,加 --json 拿结构化结果:
42model bench <模型>
测完出一张卡片,四个数:加载多久、等第一个字多久、出字多快、占了多少内存。
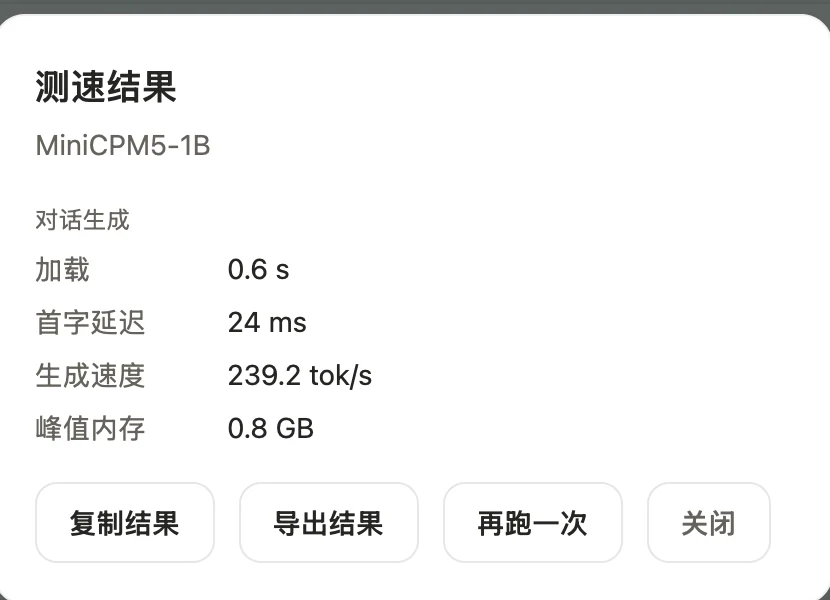
每类能力报各自该报的数
| 能力 | 报告的指标 |
|---|---|
| 对话 / 编程 | 等第一个字(TTFT)、生成速度、读入速度 |
| 翻译 | 同上三项,用真实的中英段落 |
| 语音识别 | 相对实时的倍数,以及「一分钟录音要转多久」 |
| 图文识别 | 每页多少秒 |
| 嵌入 | 每条多少毫秒 |
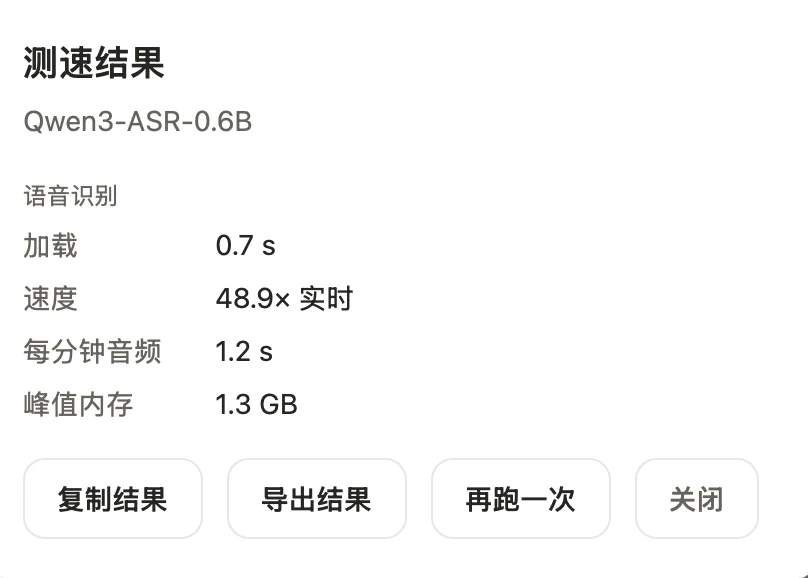
「速度」其实糊着两件事:模型回答前要先把你的问题和之前的对话读进去(读入,prefill),然后才一个字一个字写出来(生成,decode)。两段快慢相差一个数量级,还随输入长短此消彼长,所以报告把两个数分开报,你能看出慢在读还是慢在写。
报告怎么读
「复制结果」或「导出结果」得到的是一份写给人看的报告:开头一句话说完结论,指标名中文在前、英文缩写留在括号里,末尾记着哪个版本测的、记录编号是多少。报告还会写明测试负载、运行方式、芯片、内存和系统,数字连着它的来路一起读。
几点提醒:
- 测速时如果后台还常驻着别的模型,它占着内存和显卡,数字会偏低。想要干净的数,先「停止引擎」(命令行
42model serve stop)再测。 - 同一个模型在同一台机器上前后测两次,差两三成是常事——后台在跑什么、机器热不热都算数。
- 「内存占用」通常偏小,它回答的是「测的时候大概占了多少」,不是「跑这个模型需要多少内存」。后者看模型卡上的「最低 N GB」。