科研模型
长程检索与形式化证明的开源模型,以及 128GB Mac 可跑的 Intern-S2-397B。
模型库的「科研」分类收录三类模型:做长程信息检索的 deep research 模型、做形式化定理证明的模型,以及前沿档的科研大模型 Intern-S2-397B(书生-S2)。资料全程不出本机。
检索与证明模型(五个,免费)
这类模型训练的目标不是答得漂亮,而是在一个任务里连续做几十上百次判断:该搜什么、这页值不值得读、读到的东西矛盾了怎么办、什么时候收手。所以它们上下文普遍很长(多数在 131K 以上,长的到 256K),工具调用是主线。它们离开工具就不好用,当普通聊天模型问「今天天气」,体验不如同尺寸的对话模型。
| 模型 | 出品 | 方向 | 上下文 | 体积 | 建议内存 |
|---|---|---|---|---|---|
| Tongyi-DeepResearch-30B-A3B(默认推荐) | 阿里通义 | 长程信息检索 | 131K | 18.6GB | 24GB |
| MiroThinker-1.7-mini | MiroMind AI | 长程检索,按单任务 300 次工具调用设计 | 256K | 18.6GB | 24GB |
| ASearcher-Web-14B | 蚂蚁 inclusionAI | 联网搜索与网页浏览 | 131K | 9.0GB | 16GB |
| WebDancer-32B | 阿里通义 | 自主信息检索 | 40K | 19.9GB | 32GB |
| DeepSeek-Prover-V2-7B | DeepSeek | Lean 4 形式化定理证明 | — | 4.2GB | 8GB |
许可均为可商用的 Apache-2.0 或 MIT。MiroThinker-1.7-mini 上游只发布了原始权重,活水 AI 实验室自行转换并量化(61.1GB 压到 18.6GB),在 ModelScope 和 Hugging Face 同步发布,逐字节可校验。
接入检索模型
搜索和浏览的工具由你的客户端提供,活水模型负责把模型按标准协议端出来。
-
在桌面版模型库点「科研」,按内存挑一个一键下载;命令行用户:
42model download tongyi-deepresearch:30b-a3b-q4_k_m 42model serve -
把端点填进客户端(桌面版「接入」页可直接复制):
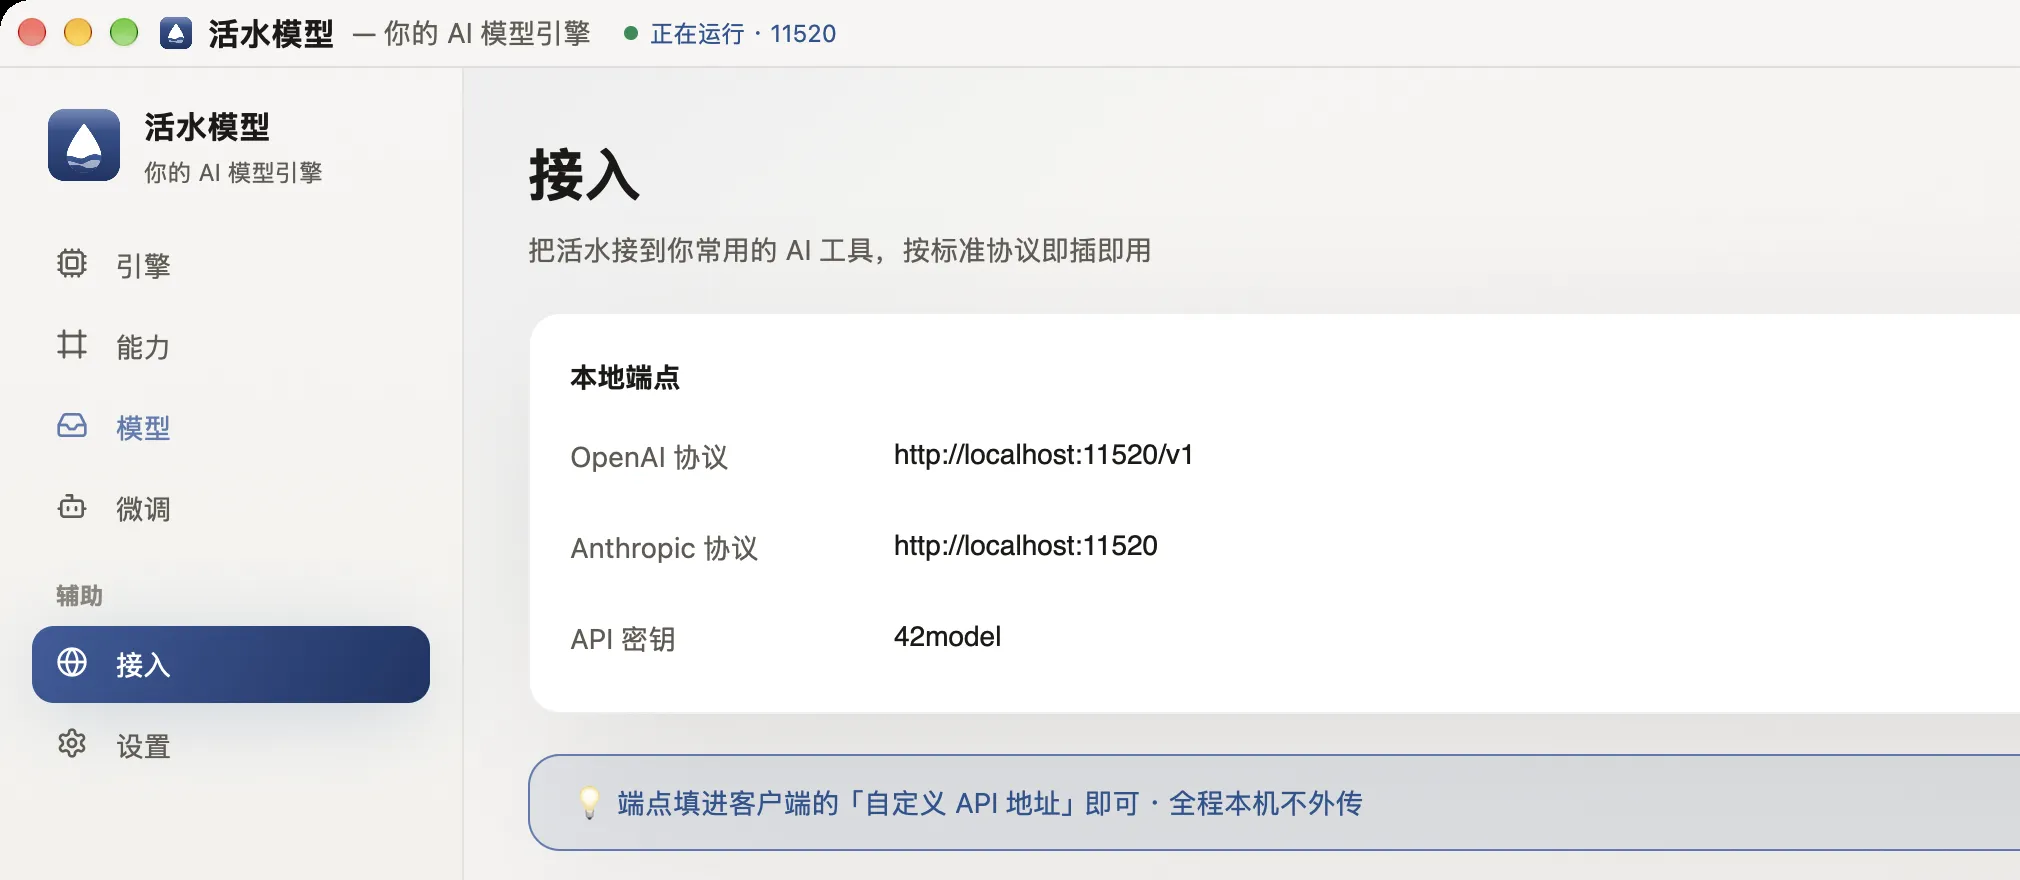
OpenAI 协议      http://localhost:11520/v1
Anthropic 协议   http://localhost:11520
API 密钥默认是
42model,可在设置里改。 -
在客户端里把模型名选成你下的那个,即模型库卡片上的 id。
之后客户端负责搜索和抓网页,模型负责判断下一步查什么。接入细节见接入 Claude Code / Codex。
用 Lean 4 证明定理
DeepSeek-Prover-V2 的输入必须是已经写成 Lean 4 的定理陈述,加上固定开头;它把 sorry 换成证明,你拿输出回 Lean 编译:
Complete the following Lean 4 code:

```lean4
theorem my_thm (n : Nat) : n + 0 = n := by
  sorry
```
先装 Lean 4 环境:官方工具链约 1GB,配套 Mathlib 编译缓存 4 到 5GB,建议预留 15GB 左右,比模型本身大得多。它服务的是已经在用 Lean 写形式化数学的人,不适合「用中文问一道数学题」。
限制
- 需要一个会给模型提供工具的客户端,搜索、浏览不在模型里,编排也不在引擎里。
- 收录的都是中小档,没有旗舰;科学多模态(化学式、蛋白序列、材料结构)暂时没有收录。
前沿档:Intern-S2-397B(书生-S2)
上海人工智能实验室研发,2026 年 9 月 13 日以 Apache-2.0 开源,MoE 结构(512 个专家,每个字请其中 10 个)。官方全精度权重约 807GB;活水模型提供压缩到 98GB 的版本,平均每个参数不到 2 比特,把对压缩最敏感的部分(如注意力层)保留在 8 比特,一台 128GB 内存的 Mac 即可运行。量化细节见大模型量化。
压缩后在一份它没见过的中文文档上与 8 比特版逐字对比,81.2% 的位置两者选出的下一个字相同。
下载
- 桌面版「模型 → 发现 → 科研」,找到 Intern-S2-397B(标着「前沿」);
- 点「一键下载」,弹出「下载前自检」;
- 在「存到哪块盘」里选外置盘(没有列出的话点「注册其它盘…」),自检会查格式、剩余空间和读写速度;
- 勾选「我已知晓风险」,点「下载」。
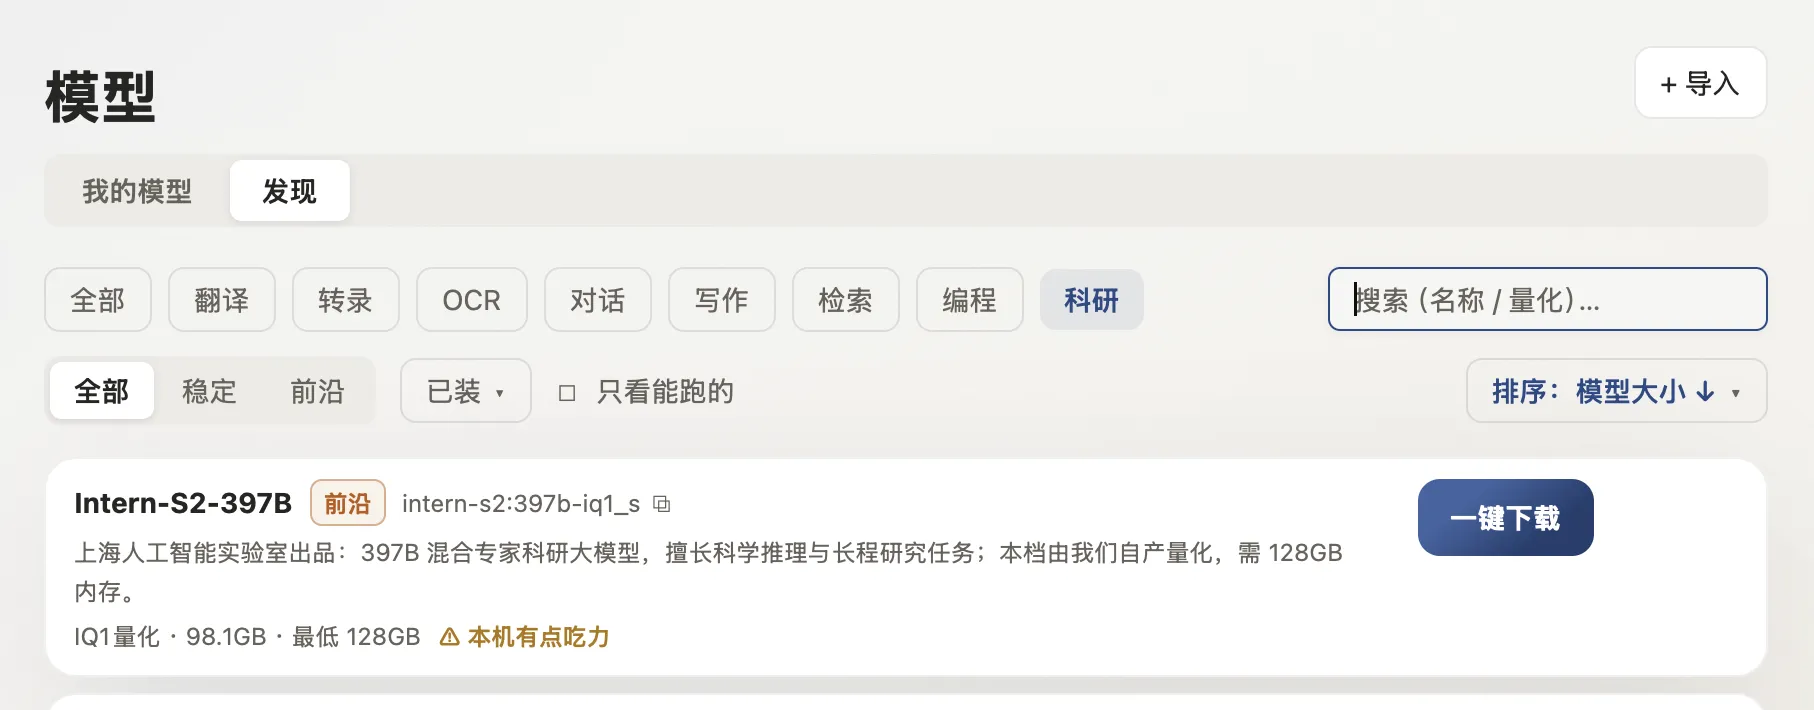
需要至少 128GB 内存,外加剩余空间 100GB 以上的外置盘(80GB 以上的前沿模型一律存外置盘)。如果列表里还没有它,重启一次活水模型即可刷新。
使用
科研类模型在桌面版里没有单独的对话页面,装好后卡片提示「在 agent 客户端中使用」。两种用法:
42model run intern-s2 "用三句话解释什么是 KL 散度"
或让常用的 AI 客户端调用它:桌面版「接入」页里有本地端点地址,按标准协议接入即可,每次提问都由你电脑上的模型回答。
实测与局限
在 Apple M3 Max(128GB)上每秒生成约 6 到 15 个 token,视上下文长短而定。四道测题里,火车到站时间应用题和 Python 代码题给出正确答案;两道中文题在设定的输出长度内还没写完思考过程。
- 速度偏慢:先想后答,思考过程比答案长得多,适合认真推一道题,不适合随口闲聊。
- 压缩很激进:与原版相比多少有损失,所以归在「前沿」实验模型。对比只在一台电脑、一份中文文档上完成,重要结论请回到原始文献核对。
- 只含文本部分:暂不支持图片输入。
- 官方自报的评测分(生命科学、竞赛数学、代码智能体等)是官方口径,不是装上就有的效果。
下一步
- 前沿档的外置盘与自检:前沿大模型
- 常见问题:个人和商业用途均可使用(Apache-2.0),保留上游版权与许可声明即可;在你电脑上下载和运行模型不收费。