模型
前沿大模型
128GB 内存的 Mac 加一块外置固态,本地流畅跑 DeepSeek-V4-Flash(2840 亿参数)。
「前沿」档收录体量接近云端旗舰的大模型。以 DeepSeek-V4-Flash 为例:总参数 2840 亿,是 MoE(混合专家)结构,每生成一个字只激活约 130 亿参数,所以一台 128GB 统一内存的 Mac 加一块合格的外置固态,就能在本地流畅运行,不联网、数据不出本机。
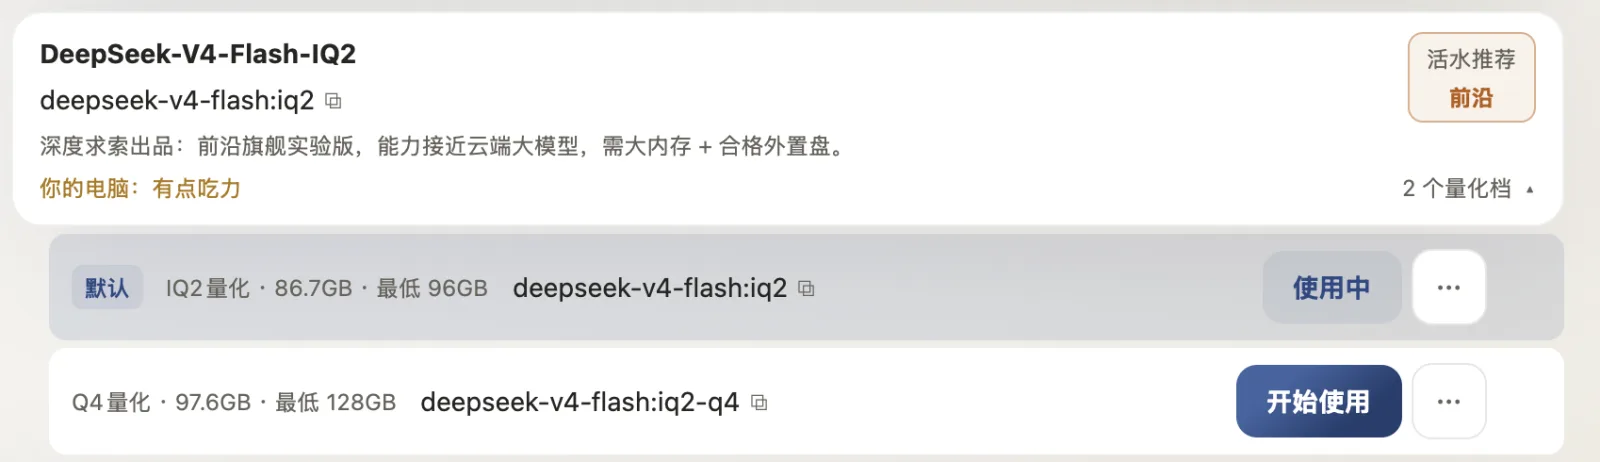
两个量化档
| 档位 | 模型 id | 体积 | 内存门槛 |
|---|---|---|---|
| IQ2 量化(默认) | deepseek-v4-flash:iq2 | 86.7GB | 96GB 起 |
| Q4 混合量化(更高质量) | deepseek-v4-flash:iq2-q4 | 97.6GB | 128GB 起 |
两档都经过精选校准。128GB 内存的机器两档皆可流畅运行,96GB 的机器可跑默认档。推理走一条为 Apple 芯片专门优化的路径(基于 MIT 协议的 ds4 引擎改造集成),与既有引擎并存。
使用条件
- 一台 128GB 统一内存的 Mac(96GB 可跑默认档);
- 一块能通过自检的外置固态硬盘。
前沿档对所有用户开放,不需要订阅。
下载与使用
在模型库的前沿档找到模型,点「下载」。下载前会先弹出完整的自检。
自检逐项确认内存是否达标、外置盘是否合格(磁盘格式、剩余空间、实测读写速度),并要求确认「实验版超大模型」的风险说明。任何一项不过关都会明确告诉你原因,不会等几十 GB 下到一半才失败。
- 只存外置盘:这类近百 GB 的超大模型一律存到检查合格的外置盘,不占用系统盘。
- 下载可中断:途中断电、拔盘、程序崩溃,重新打开后可以接着下,或干净地撤销重来,不留垃圾文件,也不损坏已装好的模型。
- 内存护栏:加载前先按硬件估算内存,装不下的拦住并说明原因。
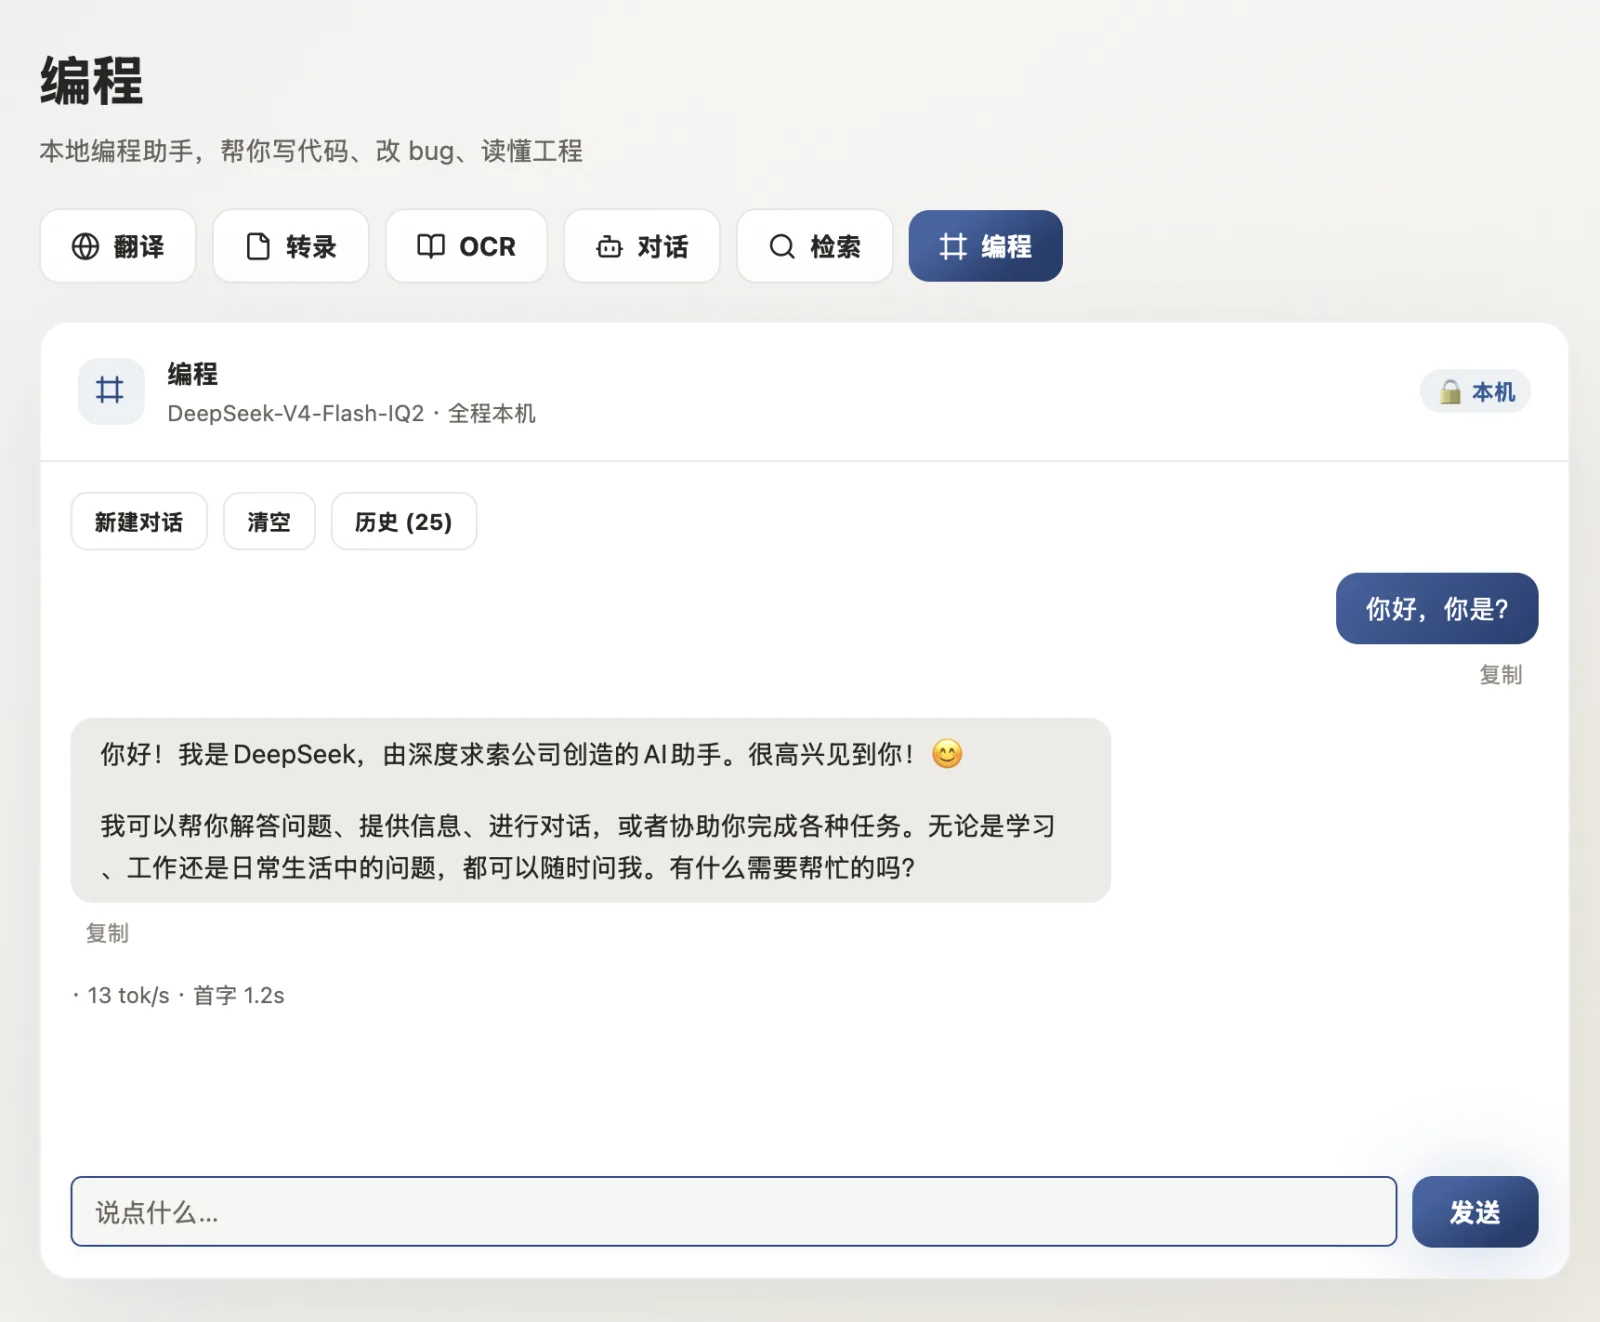
下载完成后点「开始使用」,模型会作为编程助手在「能力」页里运行,全程本机。
买外置硬盘认准三点
- 认准 NVMe 协议的固态硬盘。SATA 固态、普通机械移动硬盘速度不达标,自检过不了关;
- 配高速连接线和支持 USB4 / 雷电的硬盘盒,线材和盒子不行,再好的盘也跑不满;
- 容量至少 512GB,推荐 1TB 或 2TB。后续前沿大模型体积 300GB 起步,一步到位更省心。
实测速度
在 Apple M3 Max(128GB 内存)加 1TB NVMe 外置盘(实测读写约 2250 MB/s)上,贪心解码、凉机隔离测量:
| 量化档 | 文件大小 | 生成速度 | 剩余内存 |
|---|---|---|---|
| IQ2 | 80.8 GiB | 26.2 token/秒 | 约 40 GB |
| IQ2-Q4 | 90.9 GiB | 23.7 token/秒 | 约 30 GB |
- 26 token/秒比正常阅读速度快,对话几乎感觉不到等待。
- 模型加载进内存后就跑在内存里,硬盘只在启动时读一次,所以放外置盘不拖生成速度。
- 峰值不等于持续:笔记本长时间满载会热降频,另一次持续满载测试里,同一段任务连测三轮速度从 20.9 掉到 15.5 token/秒;散热更好的桌面机更能稳住。
- 内存不足时有「固态流式」路径:只把一部分专家缓存在内存,其余按需从盘上读取。实测用约 32GB 内存跑起了文件约 81GB 的 IQ2 档,速度从 6.3 token/秒起步,随缓存预热升到 9.1。
边界
- 实测为单机、少量任务;IQ2 与 IQ2-Q4 的输出质量差异尚未做定量评测。
- 更高的 Q4 整档量化约 153GB,128GB 装不下,需要 256GB 以上内存。
- 笔记本持续重载下速度会从峰值回落,重度使用更适合桌面机。