大模型量化
以 Intern-S2-397B 为例:把 807GB 的模型压进 128GB 内存,决定成败的几个细节。
量化就是降低数值精度来缩小体积。活水模型的前沿档模型都经过自己的精选与校准。这一页以 Intern-S2-397B 为例,记录把官方约 807GB 的全精度权重压到 98GB 时遇到的细节,供自己做量化时参考。
瓶颈在磁盘,不在算力
在一台 M3 Max 上,原始文件分放在一块 SSD 和一块 USB 机械硬盘上,整个流程拖慢我们的全是磁盘:
- 格式转换:CPU 只用到 10%,读盘每秒只有十几到二十几兆,光这一步四个多小时。
- 校准:让模型先读一批文本,记下哪些权重重要。512 个专家都可能被用到,每批文本几乎要把全部权重从盘里读一遍。把每批文本量调大四倍,读盘遍数从 20 遍降到 5 遍,两个多小时完成。
做大模型量化,先把原始文件放到最快的那块盘上。动手前也先查一遍社区是否已有配方——我们做完才发现社区作者 bartowski 已发布全套低比特版本和逐张量配方,两边独立走到了同一条原则:低比特只给路由专家,其余部分保护起来。
低比特该给谁
MTP 层要单独指定。 模型末尾的「多 token 预测」头推理时不经过,校准读不到任何数据,低比特压缩依赖的记录就缺失,压缩到第 1099 个张量(共 1118 个)时报错退出。办法是给它单独指定一个不需要校准数据的中等精度,并在正式开始前做一次「空跑」预检,几秒钟列出每个张量会被怎么处理。
敏感权重要保住。 第一版用量化工具默认配方,整体约 1.6 比特、84GB,模型彻底「说胡话」:中文回答陷入重复引号,代码反复输出同一段乱码,困惑度从 8 比特版的 4 左右涨到 48。换成官方推荐采样设置依旧崩坏,问题出在压缩上。
默认配方把注意力、线性注意力、共享专家甚至词嵌入也压到了 1 到 2 比特。这些部分加起来只有约 3GB,却是每个 token 都要经过的;约 72GB 的路由专家每次只用到一小部分,对压缩的容忍度高得多。第二版让路由专家压到 1 到 2 比特,其余基本保留 8 比特,体积只多约 14GB,四道测题恢复正常,困惑度回到 4.7 左右。差别不在压多狠,而在压哪里。
量得准,比压得狠更难
困惑度要同源、测试文本要留出。 不同程序算出的困惑度只能当量级参考。测试文本不能是校准时用过的文本——在自己的校准文本上比较,等于让学生在做过的练习题上考试。换成两份校准文本里都没有的约 2 万字中文技术文档后,各版本与原模型的困惑度差距从「约 7%」变成 9% 到 13%,排名也变了。
KL 散度比困惑度更关键。 困惑度只看模型给正确答案打了多少概率,段落之间波动大,几个版本的差距落在误差范围内。KL 散度让压缩版和 8 比特版读同一段文字,逐 token 比较两者对下一个字的整个预测分布,是一一配对的比较,误差缩到千分之三左右。
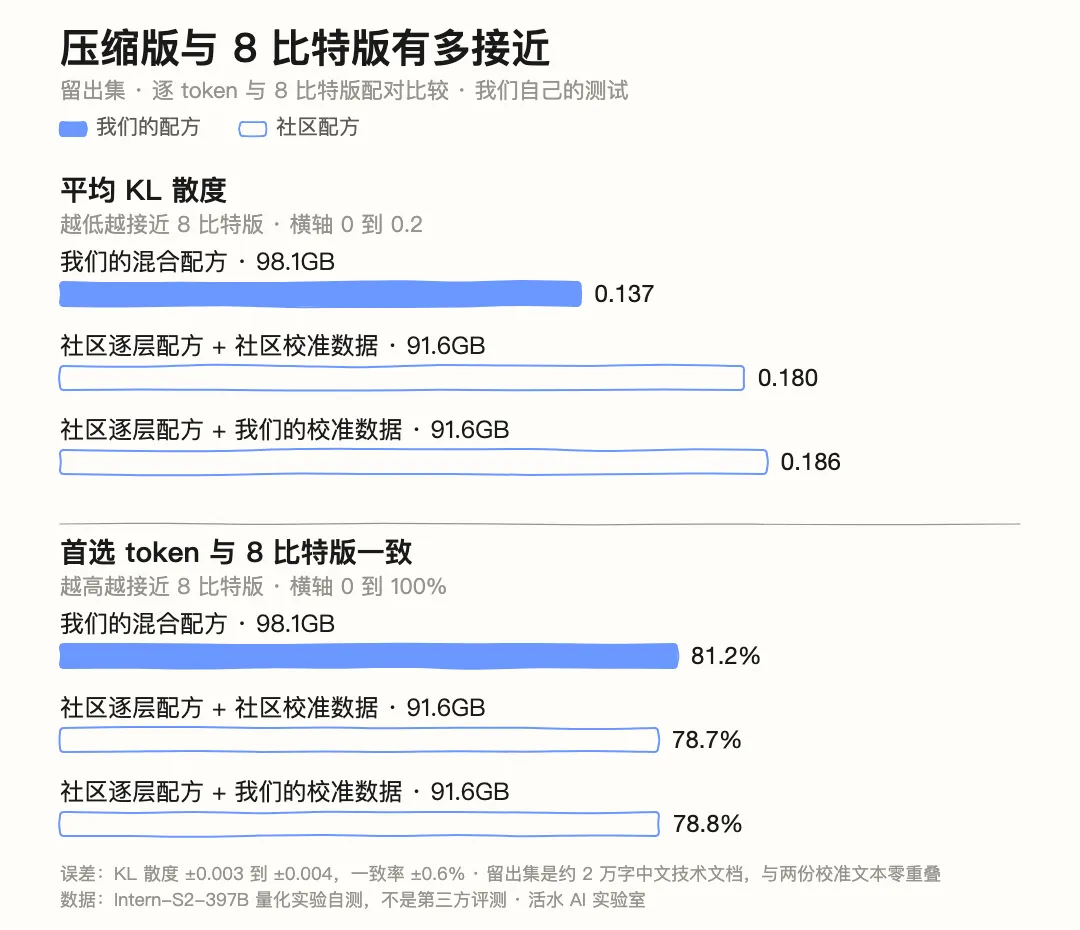
| 版本 | 体积 | KL 散度(越低越接近原模型) | 首选 token 与 8 比特版一致 |
|---|---|---|---|
| 我们的混合配方 | 98.1GB | 0.137 | 81.2% |
| 社区逐层配方 + 社区校准数据 | 91.6GB | 0.180 | 78.7% |
| 社区逐层配方 + 我们的校准数据 | 91.6GB | 0.186 | 78.8% |
多出的 6GB 换来了实打实的保真度,所以上线的是混合配方。这是我们自己的测试,不是第三方评测,只在一台电脑、一份中文文档上完成,没有跑下游基准,请当作参考而不是定论。
下一步
- 使用这个模型:科研模型